
Llm Workflow Diagnoser
Use this skill whenever a user wants to evaluate whether an existing offline / reusable workflow is worth converting into an LLM-driven workflow. Triggers on... Skill: Llm Workflow Diagnoser Owner: graysilver Summary: Use this skill whenever a user wants to evaluate whether an existing offline / reusable workflow is worth converting into an LLM-driven workflow. Triggers on... Tags: latest:0.1.0 Version history: v0.1.0 | 2026-07-23T15:18:18.015Z | auto llm-workflow-diagnoser v0.2.0 introduces an LLM-driven process to evaluate if existing offline/reusable workflows are suitabl
Rank
62
Safety
84
Downloads
3.1k
Updated
Oct 9, 2026
Version
0.1.0
Source
CLAWHUB
About
What it does, and when to use it.
Capability contract not published. No trust telemetry is available yet. 3.1K downloads reported by the source. Last updated 10/9/2026.
Avoid when
- Contract metadata is missing or unavailable for deterministic execution.
Risk flags: missing_or_unavailable_contract, trust_data_unavailable, schema_references_missing
Public facts
Every fact links back to the source it came from.
- Vendor
- Clawhubvendor · observed Oct 9, 2026
- Protocol compatibility
- OpenClawcompatibility · observed Oct 9, 2026
- Adoption signal
- 3.1K downloadsadoption · observed Oct 9, 2026
- Latest release
- 0.1.0release · observed Jul 23, 2026
- Handshake status
- UNKNOWNsecurity
Install and run
Setup complexity: low.
clawhub skill install s17c6q86pekf2pm4rzv7z5wrsd8b36w8:llm-workflow-diagnoser- Setup complexity is LOW. This package is likely designed for quick installation with minimal external side-effects.
- Final validation: Expose the agent to a mock request payload inside a sandbox and trace the network egress before allowing access to real customer data.
Contract: missing
curl -s "https://www.xpersona.co/api/v1/agents/clawhub-graysilver-llm-workflow-diagnoser/snapshot"
Documentation
CLAWHUB
21,739 characters of source documentation, loaded on request.
Extracted files
5 files captured from the source.
SKILL.md
---
name: llm-workflow-diagnoser
description: |
  Use this skill whenever a user wants to evaluate whether an existing offline / reusable workflow is worth converting into an LLM-driven workflow. Triggers on phrases like
  "这个流程要不要交给大模型做", "我有个跑得很熟的脚本流程, 能不能用 LLM 改造", "我想把这套离线流程升级成 LLM 工作流", "判断一下现在流程合不合适交给大模型",
  "LLM 改造 ROI 诊断", "评估一下大模型介入的成本收益". Always trigger when the user describes a reusable workflow and wants a go / partial / no-go decision
  plus ROI reasoning, even if they don't ask for the words "diagnose" or "ROI" explicitly. Do not trigger for one-off prompts that are not a reusable workflow,
  and do not trigger for general writing / coding tasks.
metadata:
  version: 0.2.0
---

# LLM Workflow Diagnoser

把一个已有的「离线 / 可复用流程」拆开,看它是否值得交给 LLM,输出**全量改造 / 部分改造 / 不适合**的结论 + ROI 分数 + 改造难度评级 + 落地 MVP 路线图。

整套流程由 LLM 主判,叠加一份 8 题追问清单做骨架;不允许用纯规则打分硬给结论。

## 何时使用 / 何时不使用

**触发**:

- 用户说一个明确可复用流程("我每周跑一次的报告生成脚本"、"我们客服有一套固定 FAQ 回复流程"、"我每天把日志按模板整理成周报")。
- 用户想判断它"能不能 / 该不该 / 值不值得"被 LLM 改造成工作流。
- 用户描述里同时存在触发频率 + 输入来源 + 输出形式 + 错误成本。

**不触发**:

- 一次性 prompt("帮我写一封邮件"),不是可复用流程。
- 单纯的代码重构 / bug 修复 / 写文章(请走 `clean-code-skill` / `mubai-writer-v2` / `technical-report-writer`)。
- 用户只是想做技术选型,没问"LLM 改造"。

---

## 主路径(4 步)

### Step 0:入口澄清

如果用户描述里没有提到「流程名 / 触发频率 / 输出形式」中的任意两项,先问一句:

> 你这次想诊断的「离线流程」大致叫什么名字?多久跑一次?输出长什么样?

不准默认脑补流程主题。不准直接进入追问。

### Step 1:追问(最多 6 轮,每轮 3-4 题一批)

按 `references/question_bank.md` 的 8 维度出第一组问题,每轮给 3-4 个题,用户可一次答完。

LLM 在收到回答后可补问 0-3 题,针对信息缺口。

**退出准则**(明确写进追问流程):

- 已收集到 ≥ 6 个有效回答。
- 每个维度至少有一个具体答案(不能全是"不知道 / 看情况")。
- 没有明显冲突的假设(例如用户同时说"完全不能错"和"全自动跑")。

任意一项不满足 → 继续追问;满足 → 进入诊断。

### Step 2:LLM 主判

LLM 综合判断改造建议 + 5 维度难度评级:

- **输入多样性**(难度 0-10):输入多样性越高,难度越大。
- **输出一致性要求**(难度 0-10):一致性要求越严格,难度越大。
- **容错率**(难度 0-10):容错率越低(错误代价越高),难度越大。
- **决策密度**(难度 0-10):决策越复杂 / 主观,难度越大。
- **可验证性**(难度 0-10):越难量化验证,难度越大。

按下列标准给最终建议:

| 建议 | 触发条件 |
|---|---|
| 全量改造 | 5 维度难度均值 ≤ 4 + 没有命中任何「不适合」硬护栏 + ROI 分数 ≥ 7 |
| 部分改造 | 命中 1-2 个硬护栏,或难度均值 5-7,或 ROI 分数 4-6 |
| 不适合 | 命中 ≥ 3 个硬护栏,或 ROI 分数 ≤ 3,或难度均值 ≥ 8 |

### Step 3:报告输出(必须按固定结构原文输出,**不写 .md**)

按 `references/report_template.md` 的固定结构,把六个章节**原文贴在对话回复里**:

1. 诊断说明(含 ROI 分数 xx/10)
2. LLM 介入边界
3. 改造难度评级(5 维度 xx/10 表格)
4. 落地 MVP 路线图
5. 风险清单
6. 信息缺口 / 需补充追问(如有)

**章节标题必须完全一致**。不要写 `.md` 文件、不要重命名、不要拼接、不要保存到磁盘。

---

## LLM 介入边界地图(写入报告)

报告"LLM 介入边界"章节必须按四个分类组织:

| 分类 | 含义 |
|---|---|
| **硬护栏护住** | 监管 / 合规 / 实时 / 高精度场景,LLM 不能介入;保留原人工或规则路径 |
| **仅部分场景适用** | LLM 可生成候选 / 提供多版本,但必须人工裁决 |
| **全量适用** | 决策 / 执行 / 润色都可交给 LLM,必要时保留少量校验 |
| **AI 可护住** | LLM 能补充的具体能力(生成 / 翻译 / 命名 / 检索 / 推理 / 提炼 / 数据能力边界等) |

---

## ROI 分数(强制 xx/10)

ROI 分数填在"诊断说明"章节,**必须**是 0-10 整数或一位小数:

- 9-10:极高(投入低、收益高、立即回收)
- 7-8:高(投入低-中、收益中-高、月级回收)
- 5-6:中(投入中、收益中、季级回收)
- 3-4:低(投入高、收益低、年级回收)
- 1-2:极低(投入高、收益微、不可回收)
- 0:信息不足,无法判断

ROI 分数**只允许写在"诊断说明 - ROI 分数"那一行**,其他章节不要再写一遍 ROI。

---

## 难度评级(强制 xx/10)

报告"改造难度评级"章节必须使用 Markdown 表格,列固定为:

`维度 | 难度值(xx/10,10为满分) | 解释`

5 个维度固定:

| 维度 | 难度 0 | 难度 10 |
|---|---|---|
| 输入多样性 | 高度结构化 | 自由文本 / 多模态 |
| 输出一致性要求 | 允许
README.md
# 我手头有套脚本,要不要交给 LLM?🤔 每次刷到「不接入 AI 就被淘汰」「让大模型改造一切」就开始焦虑。 但你手头那套流程跑了 N 个月,稳得一批,到底要不要冒险改造一次? 我最近发现一个**免费的诊断小工具**,专门治这种纠结。 它叫 **LLM工作流诊断工具**,专门用于诊断LLM能不能改造你工作流的Skill。 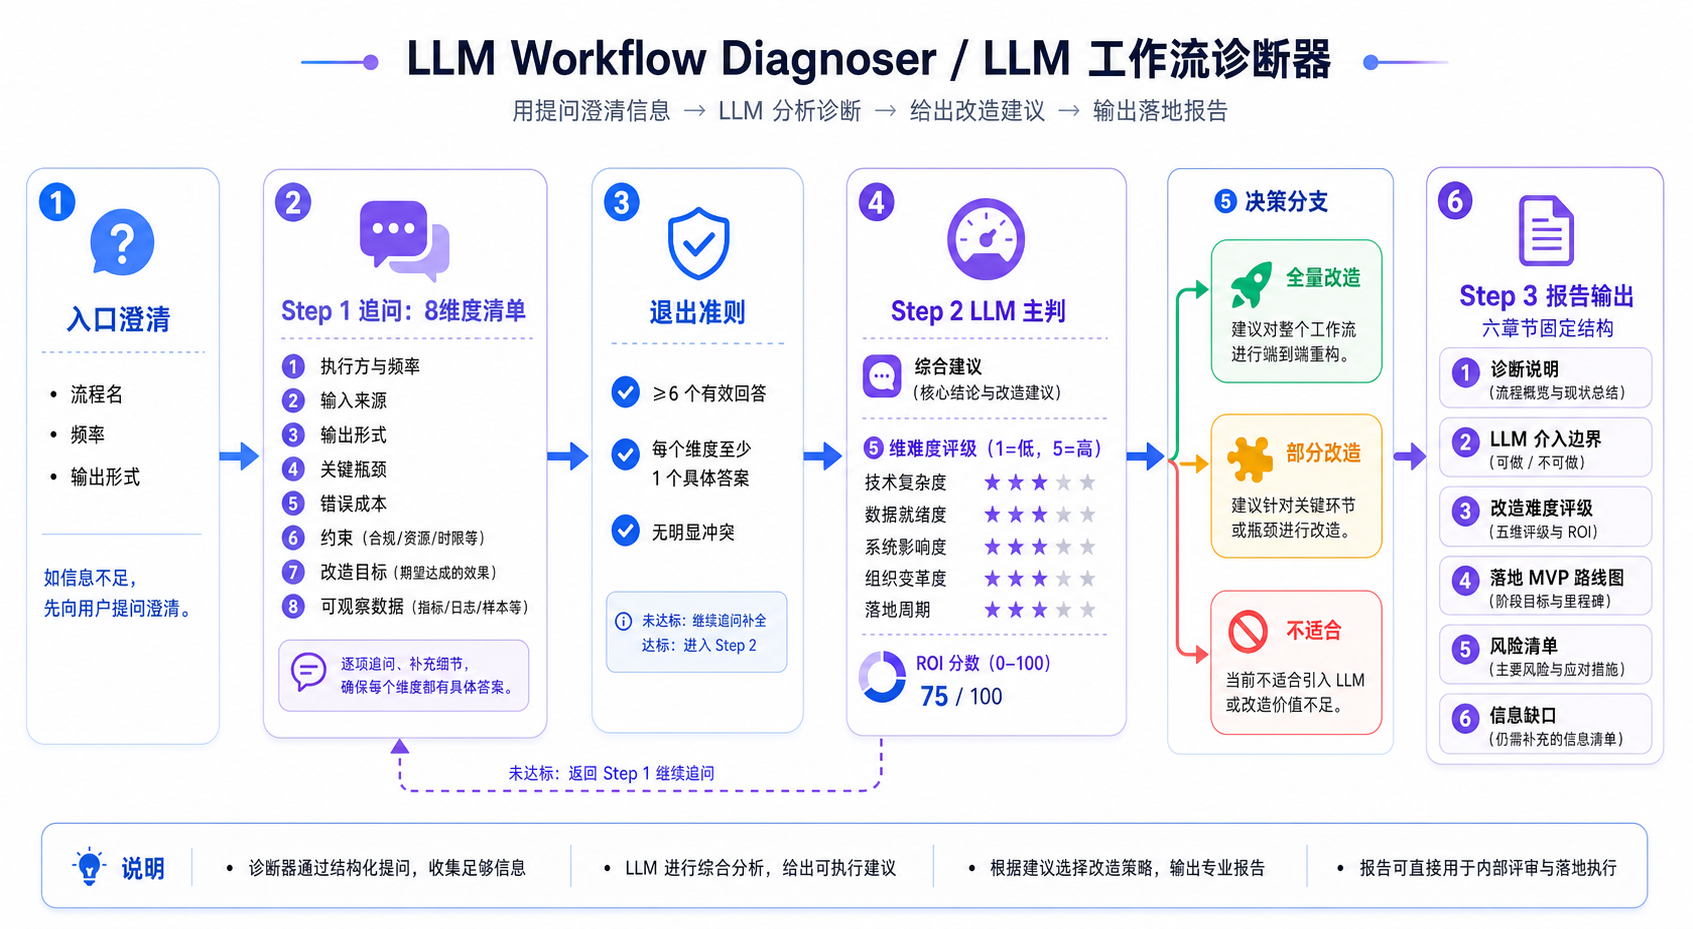 ## 一句话讲清楚它是干啥的 把你手上的「离线可复用流程」丢给它,它帮你做一次 **LLM 改造 ROI 体检**。 最后给你一句话结论:**全量改造 / 部分改造 / 不适合**,再加 ROI 分数、5 个维度难度评级、一份落地 MVP 路线图。 不是「AI 万能」的鸡汤,也不是「看情况」就完事的废话。 ## 怎么用,4 步走 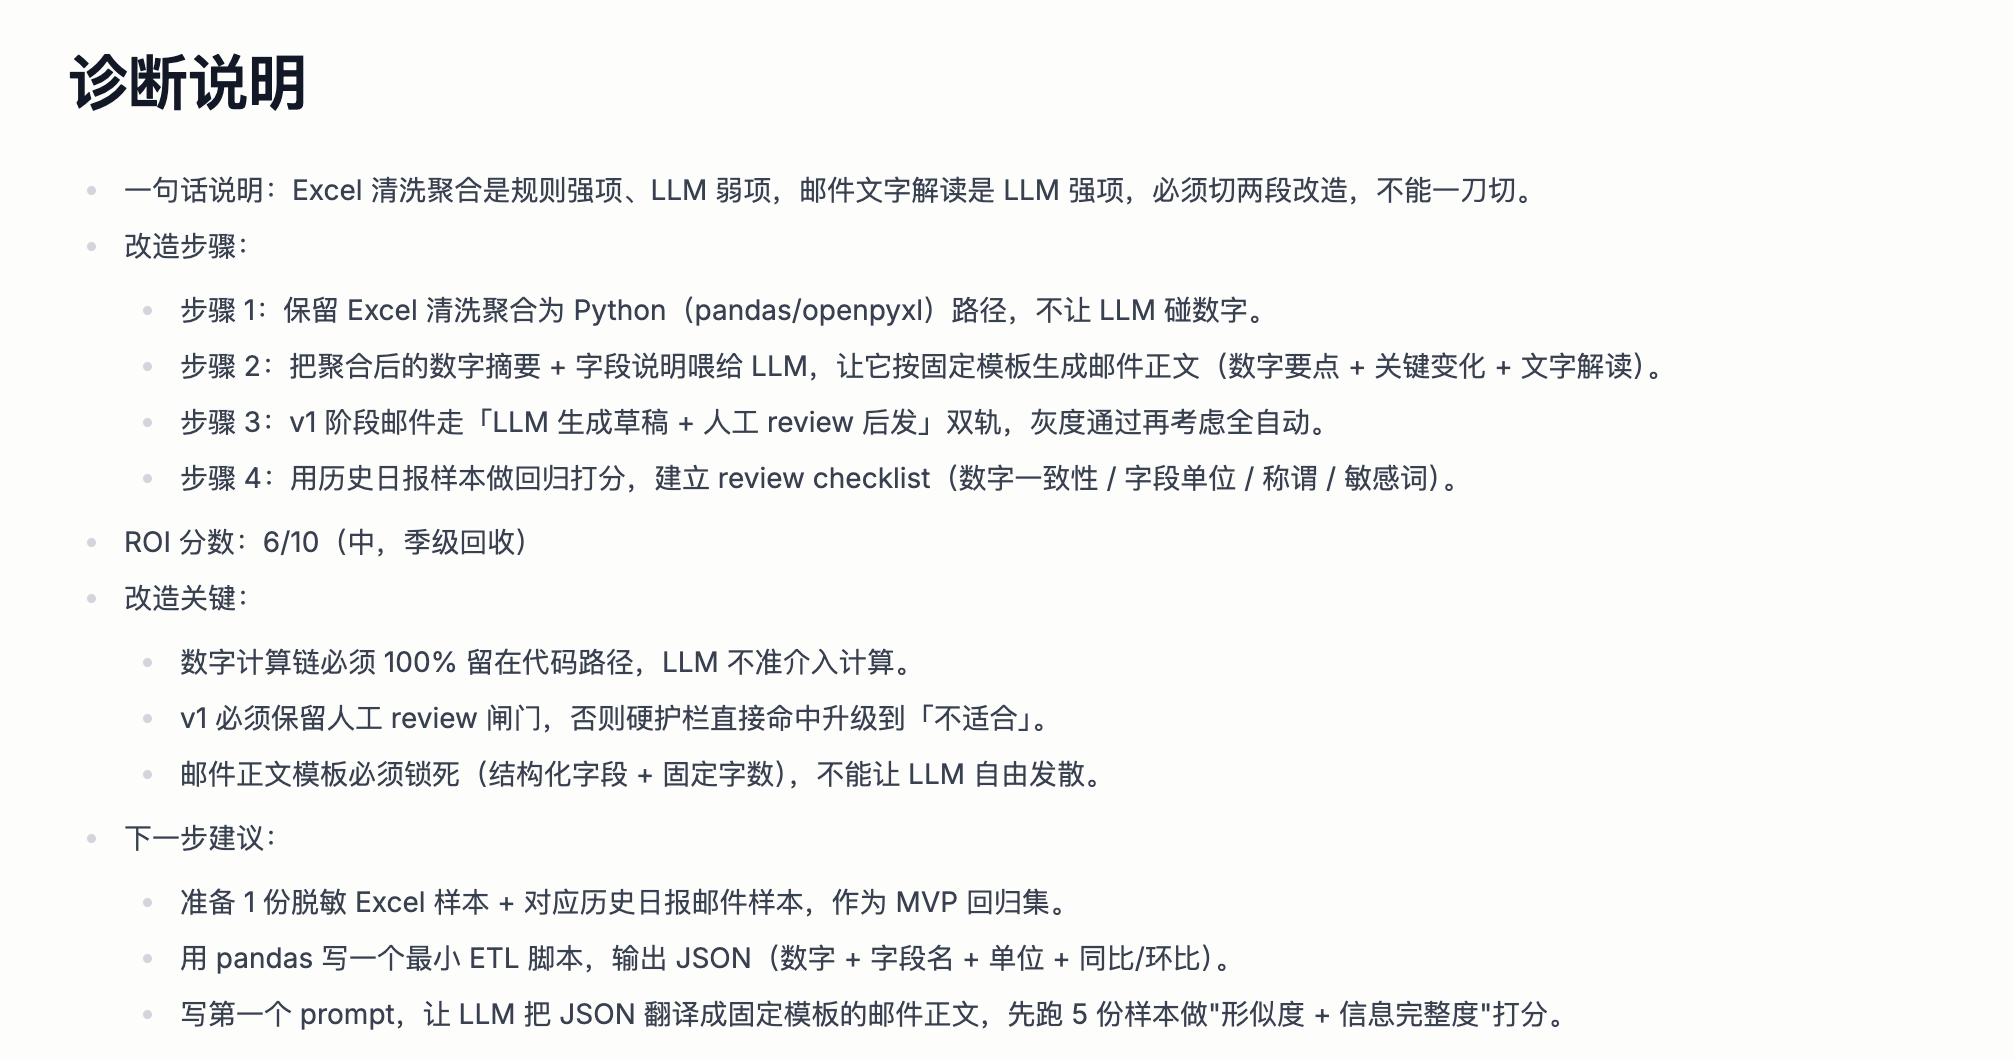 不用下载不用注册,装上 Skill 直接用。 **Step 0,入口澄清** 问你:你这套流程叫啥、多久跑一次、输出长啥样。老实交代就行。 **Step 1,8 维度追问,最多 6 轮** 从执行方、输入、输出、瓶颈、容错、约束、目标、可观察数据,8 个角度连环问。每轮 3-4 题一批,你一次答完就行。 **Step 2,LLM 主判** 不靠纯规则打分,综合所有回答给: - ROI 分数(xx/10) - 改造建议(全量 / 部分 / 不适合) - 5 维度难度评分(输入多样性、输出一致性、容错率、决策密度、可验证性) **Step 3,原文输出报告** 一份六章节诊断报告直接贴在对话里,不写 .md。你看完心里就有数了。 ## 我特别喜欢的几个细节 **有硬护栏**,监管、合规、实时、高精度场景,它直接劝你别上 LLM。不会为了讨好你说"都可以试试"。 **追问有退出准则**,6 个有效回答 + 每个维度有具体答案才下结论。不会你才说了两句它就拍脑袋给判断。 **报告不写假数据**,关键假设和没问到的问题会显式列出来,让你知道哪里还藏着雷。  ## 适合谁用 ✅ 每周/每天跑同一套脚本流程的工程师 ✅ 客服有固定 FAQ 回复流程的运营 ✅ 想把日志/数据整理成周报的数据同学 ✅ 任何手里有「可复用流程 + 想过要不要上 LLM」的人 ❌ 一次性 prompt("帮我写封邮件"那种不算流程) ❌ 单纯想重构代码或修 bug ❌ 只是想做技术选型,没问"LLM 改造" --- 过去纠结「该不该上 LLM」这种事,要么靠老板拍脑袋,要么靠朋友支招,要么靠自己 YY。 现在有个**免费 + 结构化**的诊断工具直接拿过来用,挺香。
_meta.json
{
  "ownerId": "kn7d9j0s3r1dyyhk54hpgdpe358b27pz",
  "slug": "llm-workflow-diagnoser",
  "version": "0.1.0",
  "publishedAt": 1784819898015
}
references/examples/full_replace.md
# 全量改造示例:跨平台营销文案流水线

> 用途:写报告前对照风格,不内嵌到主报告里。
> 注意:示例展示的是"报告原文贴在 Chat"的效果,章节标题、表格格式必须完全一致。

## 用户上下文

- 流程名:跨平台营销文案生成。
- 触发:每周一次,运营手动写 20 条推文 / 朋友圈 / 小红书。
- 输入:本周产品更新要点 + 受众标签。
- 输出:3 个平台各 1 套文案 + 配图建议。
- 错误成本:低(人工可改,可回滚)。
- 改造目标:把"20 条文案从 4 小时压缩到 30 分钟"。

---

## 报告原文示例(应直接复制此结构)

```text
# 诊断说明
- 一句话说明:跨平台文案生成是高容错 + 多样化输出的典型 LLM 全量改造场景,可压到月级回收。
- 改造步骤:
  - 步骤 1:固化「产品要点 + 受众标签 → 三平台文案」的 prompt 模板
  - 步骤 2:用最近 4 周历史素材做对照验证,统计一次通过率
  - 步骤 3:灰度 50% 流量到 LLM 路径,老流程并行兜底
  - 步骤 4:监控互动率后下线老流程
- ROI 分数:8/10(10为满分)
- 改造关键:
  - 关键 1:受众多样化 + 文案允许多版本,LLM 能直接打主力
  - 关键 2:互动率可量化衡量改造效果
  - 关键 3:人工兜底成本可接受
- 下一步建议:
  - 建议 1:先跑 1 周端到端验证
  - 建议 2:建立「一次通过率 / 互动率」两道监控
  - 建议 3:法务相关文案保留人工复核

# LLM 介入边界
- 硬护栏护住:无
- 仅部分场景适用:法务 / 行业合规相关文案,需人工复核
- 全量适用:跨平台改写、文案初稿、配图建议、CTA 优化
- AI 可护住:生成(多平台文案)、推理(CTA 排序)、设计(多版本对比)、检索(历史高互动素材)

# 改造难度评级

维度	| 难度值(xx/10,10为满分)|解释
输入多样性	| 3/10(10为满分)| 产品要点半结构化,受众标签可控
输出一致性要求	| 2/10(10为满分)| 多平台风格本身要求多样化
容错率	| 2/10(10为满分)| 文案可人工润色,可回滚
决策密度	| 4/10(10为满分)| 需判断"哪个角度最能打"
可验证性	| 3/10(10为满分)| 有 CTR / 互动率数据

# 落地 MVP 路线图
- MVP 步骤 1:拿最近 1 周产品更新,让 LLM 生成 3 平台 × 5 版文案,人工对比
- MVP 步骤 2:运营在新流程上跑 2 周,老流程并行作对照
- MVP 步骤 3:下线老流程,保留人工兜底通道与互动率监控

# 风险清单
- 风险 1:LLM 文案风格漂移 → 缓解:固化 prompt + 风格样例库
- 风险 2:互动率不升反降 → 缓解:保留老流程做 4 周 A/B 对照
- 风险 3:法务合规文案误用 → 缓解:合规相关字段强制人工审核
```
references/examples/not_suitable.md
# 不适合示例:高频交易信号生成

> 用途:写报告前对照风格,不内嵌到主报告里。
> 注意:示例展示的是"报告原文贴在 Chat"的效果,章节标题、表格格式必须完全一致。

## 用户上下文

- 流程名:高频交易信号生成。
- 触发:每秒数百次。
- 输入:实时行情(结构化数值流)。
- 输出:买入 / 卖出 / 持仓信号。
- 错误成本:极高(一次错信号可能造成重大资金损失)。
- 改造目标:希望用 LLM "更快" 出信号。

---

## 报告原文示例(应直接复制此结构)

```text
# 诊断说明
- 一句话说明:高频交易信号同时命中实时 + 高精度 + 高合规三个硬护栏,LLM 不能进生产路径。
- 改造步骤:
  - 步骤 1:保持原实时信号生成脚本不变
  - 步骤 2:把 LLM 隔离在盘后复盘场景,不进生产路径
  - 步骤 3:用 LLM 做异常信号归因与策略回顾
- ROI 分数:1/10(10为满分)
- 改造关键:
  - 关键 1:实时性 + 零容错 + 高合规三大硬护栏同时命中
  - 关键 2:LLM 推理延迟不可能压到毫秒级
  - 关键 3:错信号直接进生产路径,无法批量回滚
- 下一步建议:
  - 建议 1:放弃「让 LLM 直接出信号」的想法
  - 建议 2:把 LLM 用在盘后复盘 / 异常归因
  - 建议 3:保留当前脚本与回放框架,不引入 LLM 链路

# LLM 介入边界
- 硬护栏护住:实时信号生成、毫秒级决策、生产路径写入
- 仅部分场景适用:盘后复盘报告、异常信号归因
- 全量适用:无
- AI 可护住:检索(复盘历史)、推理(归因假设),但都不可直接进生产路径

# 改造难度评级

维度	| 难度值(xx/10,10为满分)|解释
输入多样性	| 2/10(10为满分)| 行情字段固定
输出一致性要求	| 9/10(10为满分)| 信号必须严格一致
容错率	| 10/10(10为满分)| 错信号直接进生产路径
决策密度	| 5/10(10为满分)| 信号生成有规则
可验证性	| 2/10(10为满分)| 有完整回测与回放框架

# 落地 MVP 路线图
- MVP 步骤 1:明确把 LLM 隔离在盘后复盘场景
- MVP 步骤 2:用 LLM 做异常信号归因,输出归因假设给人工审核
- MVP 步骤 3:不引入任何进生产路径的 LLM 链路

# 风险清单
- 风险 1:把 LLM 引入实时链路造成延迟 → 缓解:明确隔离边界
- 风险 2:复盘归因被误用为生产信号 → 缓解:复盘输出必须经人工审核才可入决策
- 风险 3:误判 ROI 偏高 → 缓解:以实时性 / 合规为否决项
```
activepieces
AI Agents & MCPs & AI Workflow Automation • (~400 MCP servers for AI agents) • AI Automation / AI Agent with MCPs • AI Workflows & AI Agents • MCPs for AI Agents
cherry-studio
AI productivity studio with smart chat, autonomous agents, and 300+ assistants.
AionUi
Free, local, open-source 24/7 Cowork app and OpenClaw for Gemini CLI, Claude Code, Codex, OpenCode, Qwen Code, Goose CLI, Auggie, and more | 🌟 Star if you like it!
CopilotKit
The Frontend for Agents & Generative UI. React + Angular
Machine-readable data
The same record, as JSON, for agents and crawlers.
{
  "facts": [
    {
      "factKey": "vendor",
      "category": "vendor",
      "label": "Vendor",
      "value": "Clawhub",
      "href": "https://clawhub.ai/graysilver/skills/llm-workflow-diagnoser",
      "sourceUrl": "https://clawhub.ai/graysilver/skills/llm-workflow-diagnoser",
      "sourceType": "profile",
      "confidence": "medium",
      "observedAt": "2026-10-09T09:47:39.182Z",
      "isPublic": true
    },
    {
      "factKey": "protocols",
      "category": "compatibility",
      "label": "Protocol compatibility",
      "value": "OpenClaw",
      "href": "https://www.xpersona.co/api/v1/agents/clawhub-graysilver-llm-workflow-diagnoser/contract",
      "sourceUrl": "https://www.xpersona.co/api/v1/agents/clawhub-graysilver-llm-workflow-diagnoser/contract",
      "sourceType": "contract",
      "confidence": "medium",
      "observedAt": "2026-10-09T09:47:39.182Z",
      "isPublic": true
    },
    {
      "factKey": "traction",
      "category": "adoption",
      "label": "Adoption signal",
      "value": "3.1K downloads",
      "href": "https://clawhub.ai/graysilver/llm-workflow-diagnoser",
      "sourceUrl": "https://clawhub.ai/graysilver/llm-workflow-diagnoser",
      "sourceType": "profile",
      "confidence": "medium",
      "observedAt": "2026-10-09T09:47:39.182Z",
      "isPublic": true
    },
    {
      "factKey": "latest_release",
      "category": "release",
      "label": "Latest release",
      "value": "0.1.0",
      "href": "https://clawhub.ai/graysilver/llm-workflow-diagnoser",
      "sourceUrl": "https://clawhub.ai/graysilver/llm-workflow-diagnoser",
      "sourceType": "release",
      "confidence": "medium",
      "observedAt": "2026-07-23T15:18:18.015Z",
      "isPublic": true
    },
    {
      "factKey": "handshake_status",
      "category": "security",
      "label": "Handshake status",
      "value": "UNKNOWN",
      "href": "https://www.xpersona.co/api/v1/agents/clawhub-graysilver-llm-workflow-diagnoser/trust",
      "sourceUrl": "https://www.xpersona.co/api/v1/agents/clawhub-graysilver-llm-workflow-diagnoser/trust",
      "sourceType": "trust",
      "confidence": "medium",
      "observedAt": null,
      "isPublic": true
    }
  ],
  "events": [
    {
      "eventType": "release",
      "title": "Release 0.1.0",
      "description": "llm-workflow-diagnoser v0.2.0 introduces an LLM-driven process to evaluate if existing offline/reusable workflows are suitable for LLM transformation. - Adds a step-by-step workflow: entry clarification, up to 6 rounds of 8-dimension questioning, LLM-based judgment with difficulty/ROI scoring, and structured report output. - Defines strict trigger/exclusion criteria to ensure correct activation only for reusable workflows seeking LLM transformation assessment. - Report output standardized into six fixed sections, including clear ROI score (0–10) and detailed difficulty ratings across five dimensions. - Integrates safeguard rules: prohibits skipping questions, using only rules-based scoring, or outputting reports to files. - Includes comprehensive guidance on boundary cases, mandatory question structure, and stepwise interaction flow.",
      "href": "https://clawhub.ai/graysilver/llm-workflow-diagnoser",
      "sourceUrl": "https://clawhub.ai/graysilver/llm-workflow-diagnoser",
      "sourceType": "release",
      "confidence": "medium",
      "observedAt": "2026-07-23T15:18:18.015Z",
      "isPublic": true
    }
  ]
}
Record generated Oct 9, 2026.